Einleitung
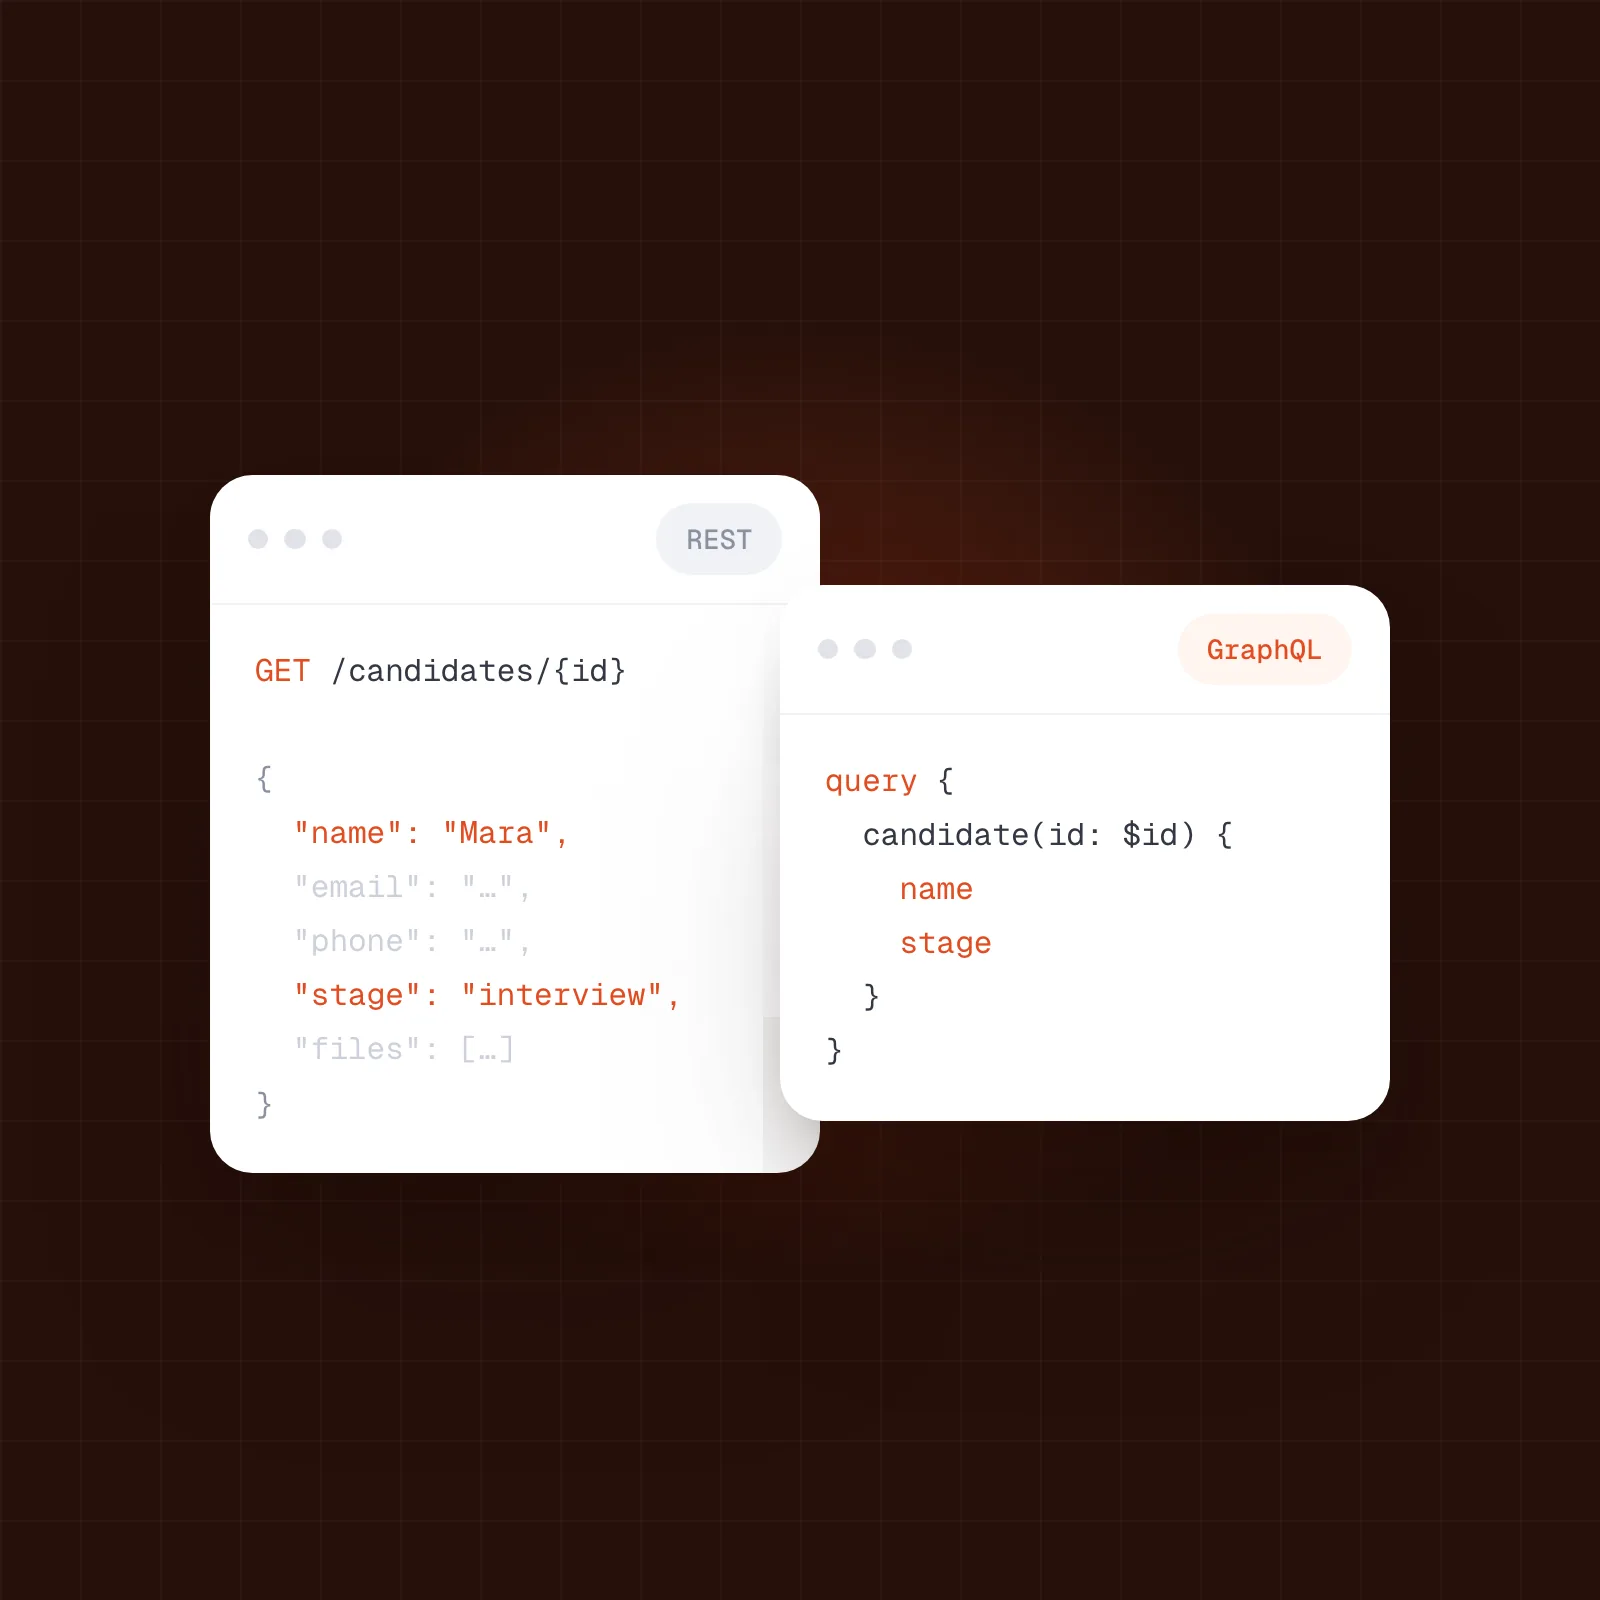
Du sollst ein Bewerbermanagementsystem an zwei Jobbörsen anbinden. Im Kickoff fällt die Frage, ob ihr das „modern mit GraphQL" oder „klassisch über REST" löst. Zwei Wochen später stellst du fest: Das ATS liefert Stellen über eine REST-Schnittstelle mit eigenem Auth-Schema, die Jobbörse verlangt ein anderes Feldformat, und über den API-Stil hat niemand in deinem Team je entschieden – er stand schon fest, bevor das Projekt begann.
Dieser Beitrag ist für Tech Leads und Entwicklerinnen, die Recruiting-Systeme miteinander verbinden müssen. Er ordnet ein, wann die Wahl überhaupt bei dir liegt, was unabhängige Studien zur GraphQL-Performance tatsächlich messen – nicht, was Marketing-Blogs daraus machen – und wo Over-Fetching, Versionierung und Rate Limiting tatsächlich Aufwand verursachen. Die kurze Antwort vorweg: Der Stil ist selten das Problem. Die Fragen, die tatsächlich Zeit kosten, betreffen Auth-Verfahren, Feldsemantik und die Frage, wer eine Änderung an der fremden API überhaupt merkt, bevor sie live geht.
TL;DR
- REST bleibt der Standard: 93 % der Entwickelnden nutzen REST, 33 % zusätzlich GraphQL – die beiden schließen sich in der Praxis nicht aus (Postman, State of the API 2025).
- In einer Studie an echten Microservices lag REST bei der Antwortzeit rund 3,4-mal vorn (≈250 ms gegen ≈850 ms), während REST insgesamt fast 4 GB Daten übertrug, GraphQL nur einige hundert MB (Elghazal, Aneiba & Shahra, WEBIST 2025).
- Für datenintensive, tief verschachtelte Leseoperationen maß eine Studie der University of Washington Tacoma 25–67 % niedrigere Antwortzeiten für GraphQL – bei schwächerer Skalierung unter sehr hoher Last (Jin, UW Tacoma ResearchWorks, 2025).
- Oberhalb von 3.000 Requests fiel GraphQL in einer weiteren Studie hinter REST zurück; bei kleinen Lasten von 100 Requests unterschieden sich beide kaum (Seabra, Nazário & Pinto, SBCARS 2019).
- Nur 26 % der Teams versionieren ihre APIs semantisch, obwohl 60 % überhaupt versionieren (Postman, State of the API 2025) – das eigentliche Integrationsrisiko liegt hier, unabhängig vom Stil.
- 69 % der 160 öffentlich erreichbaren GraphQL-Endpunkte, die Escape 2024 scannte, hatten Schwachstellen mit Bezug zu unkontrolliertem Ressourcenverbrauch – dem Haupteinfallstor für Denial-of-Service (Escape, State of GraphQL Security 2024).
Wer entscheidet bei einer eingehenden ATS-Integration über den API-Stil?
Der Anbieter des Systems, das du anbindest – nicht du. Bei einer eingehenden Integration konsumierst du eine fremde Schnittstelle in der Form, in der sie existiert. Ein REST-basiertes Bewerbermanagementsystem lässt sich nicht per Teamentscheidung zu GraphQL machen. Wahlfreiheit besteht ausschließlich für die API, die du selbst herausgibst.
Das klingt trivial, ist aber der häufigste Denkfehler in Integrationsprojekten. „REST gegen GraphQL" ist eine Design-Debatte für eigene APIs. Sobald fremde Systeme angebunden werden, wird daraus eine Übersetzungsaufgabe: Du arbeitest mit dem, was da ist, und musst nach außen trotzdem eine konsistente Form anbieten.
| Situation | Wer bestimmt den Stil | Deine eigentliche Frage |
|---|---|---|
| Du bindest ein ATS an | Der ATS-Anbieter | Wie normalisierst du heterogene Formate? |
| Du bindest eine Jobbörse an | Die Plattform | Wie erfüllst du deren Pflichtfelder? |
| Du gibst eine eigene API heraus | Du | REST, GraphQL oder beides? |
| Du baust ein internes Frontend | Du | Wie viele Roundtrips brauchst du? |
Diese Unterscheidung ist der Grund, warum eine betriebene Verbindungsschicht zwischen ATS und Kanälen für viele Teams mehr Aufwand spart als eine Stilentscheidung: Die Vielfalt der angebundenen Systeme verschwindet dadurch nicht, aber jemand anders trägt die Übersetzungsarbeit.
Welche API-Stile triffst du im Recruiting-Tech-Stack tatsächlich an?
Überwiegend REST mit JSON, daneben REST-Derivate mit eigener Konvention. Zwei Beispiele, die in diesem Artikel als Referenz dienen: SAP SuccessFactors liefert seine Talent-Management-Daten über OData-V2-APIs aus (ServiceNow-Dokumentation zur SuccessFactors-Anbindung, 2026) – REST mit eigener Query-Syntax für Filter, Expansion und Paginierung. Teamtailor dagegen folgt der JSON:API-Spezifikation, einer strengeren REST-Konvention für Relationen und eingebettete Ressourcen, und authentifiziert Zugriffe über einen in den Kontoeinstellungen erzeugten API-Key (Teamtailor Support Center, 2026).
Keines der beiden Systeme bietet GraphQL an. Das ist kein Zufall: GraphQL macht laut Postmans Erhebung 33 % der API-Landschaft insgesamt aus, konzentriert sich dort aber überwiegend auf eigene Produkt- und Mobil-Backends, nicht auf die HR- und Recruiting-Systeme, die diese Backends anbinden (Postman, State of the API 2025). Wer ein ATS oder ein HR-System anbindet, konsumiert also praktisch immer eine REST-artige Schnittstelle – mit Sonderfällen wie OData oder JSON:API, aber ohne GraphQL.
Diese Vielfalt ist kein Übergangszustand, der sich in zwei Jahren auflöst. Viele dieser Systeme laufen seit über einem Jahrzehnt bei Konzernkunden in gewachsenen Konfigurationen und werden nicht neu gebaut, weil ein Integrationspartner sich das wünscht. Wer mehrere solcher Systeme gleichzeitig anbindet, verbringt einen erheblichen Teil der Projektzeit nicht mit dem API-Stil, sondern mit Auth-Verfahren, Paginierung und Feldsemantik – Themen, die eine ATS-Anbindung im Kern ausmachen, unabhängig davon, ob am Ende REST, OData oder JSON:API drinsteht.
Was zeigen die Performance-Studien tatsächlich – und was nicht?
Kein einheitliches Bild, sondern eines, das stark vom Szenario abhängt. Drei unabhängige Messungen kommen zu unterschiedlichen, teils gegensätzlichen Ergebnissen, weil sie unterschiedliche Dinge testen.
| Studie | Setup | Kernergebnis |
|---|---|---|
| Jin, UW Tacoma (2025) | Serverless, 10,9-Mio.-Zeilen-Datensatz, AWS | 25–67 % niedrigere Latenz für GraphQL bei datenintensiven Operationen; schwächere Skalierung unter sehr hoher Last |
| Elghazal, Aneiba & Shahra, WEBIST 2025 | Go-Microservices, kontrollierter Testaufbau | REST rund 3,4-mal schneller in der Antwortzeit; REST übertrug insgesamt fast 4 GB, GraphQL einige hundert MB |
| Seabra, Nazário & Pinto, SBCARS 2019 | Drei produktive Webanwendungen, Migration REST → GraphQL | GraphQL verbesserte Requests/Sek. und Transferrate in zwei von drei Apps; oberhalb von 3.000 Requests fiel GraphQL hinter REST zurück |
Die Studie der University of Washington Tacoma zeigt GraphQL im Vorteil, wenn eine Abfrage mehrere verschachtelte Ressourcen in einem Aufruf zusammenführt – aber ausdrücklich nicht bei sehr hoher Parallelität, wo die Skalierung schwächer war als bei REST (Jin, UW Tacoma ResearchWorks, 2025). Elghazal, Aneiba und Shahra kommen im direkten Vergleich auf ein anderes Bild: Bei ihnen war REST in der Antwortzeit klar schneller, GraphQL dafür deutlich sparsamer im übertragenen Datenvolumen (Elghazal, Aneiba & Shahra, WEBIST 2025). Seabra, Nazário und Pinto beobachteten in Produktionsanwendungen eine dritte Variante: GraphQL half bei kleinen und mittleren Lasten, verlor den Vorteil aber oberhalb von 3.000 Requests (Seabra, Nazário & Pinto, SBCARS 2019).
Der gemeinsame Nenner: Keine der drei Studien stützt die pauschale Aussage „GraphQL ist schneller" oder ihr Gegenteil. Alle drei stützen dieselbe praktische Regel – GraphQL gewinnt bei tief verschachtelten Lesezugriffen mit moderater Parallelität, REST gewinnt bei hoher Last und einfachen Zugriffsmustern. Für Server-zu-Server-Synchronisation zwischen ATS und Jobbörse, die nachts in Batches läuft, ist das zweite Muster das relevantere.
Warum die drei Studien unterschiedlich ausfallen, ist selbst aufschlussreich. Sie unterscheiden sich nicht nur im Ergebnis, sondern in dem, was sie überhaupt gemessen haben: Jin, Cordingly, Zhao und Lloyd testen eine serverlose Umgebung mit einem einzigen, sehr großen Datensatz und variieren die Abfragetiefe. Elghazal, Aneiba und Shahra testen klassische, dauerhaft laufende Microservices unter konstanter Last. Seabra, Nazário und Pinto testen drei produktive Anwendungen vor und nach einer echten Migration, nicht ein synthetisches Benchmark-Setup. Wer eine einzelne Zahl aus einer dieser Studien zitiert, ohne das Setup zu nennen, überträgt ein Ergebnis auf ein Szenario, das die Studie nie getestet hat – genau der Fehler, den Marketing-Vergleiche zwischen REST und GraphQL am häufigsten machen.
Was kostet Over-Fetching wirklich, und wo hilft GraphQL nicht?
Weniger als das Argument suggeriert, aber messbar beim Datenvolumen. In der WEBIST-2025-Messung überträgt REST deutlich mehr Daten als GraphQL, ohne dass daraus automatisch eine langsamere Antwortzeit folgt – REST war trotz des größeren Datenvolumens schneller (Elghazal, Aneiba & Shahra, WEBIST 2025). Over-Fetching ist damit vor allem ein Bandbreiten- und Mobilfunkproblem, kein pauschales Performance-Problem.
Für Server-zu-Server-Synchronisation zwischen einem ATS und einer Jobbörse ist Bandbreite selten der Engpass. Der Engpass sind Rate Limits des Anbieters, Pagination über zehntausende Datensätze und Felder, die je Kunde anders belegt sind.
| Problem | Löst GraphQL das? | Was in der Praxis hilft |
|---|---|---|
| Zu viele Felder pro Antwort | Ja | Bei Server-zu-Server-Sync meist unkritisch |
| Zu viele Roundtrips im Frontend | Ja | Auch mit REST-Batch-Endpoints machbar |
| Rate Limits des Anbieters | Nein | Backoff, Caching, Delta-Sync |
| Uneinheitliche Feldsemantik | Nein | Normalisierung mit Rohwert und Standardwert |
| Undokumentierte Custom Fields | Nein | Auto-Discovery und Mapping-Oberfläche |
Vier von fünf typischen Integrationsproblemen bleiben unabhängig vom API-Stil bestehen. Das ist der entscheidende Punkt: Der Stil ist selten die Ursache des Aufwands, den ein Team beim Rückweg der Kandidatendaten tatsächlich spürt – das ist meist Feldsemantik, nicht Transportformat.
Wie unterscheiden sich Versionierung und Breaking Changes?
REST versioniert typischerweise über den Pfad, GraphQL über Feld-Deprecation im Schema – beides funktioniert nur, wenn der Anbieter disziplinierter arbeitet als der Durchschnitt. 60 % der Teams versionieren ihre APIs überhaupt, aber nur 26 % nutzen semantische Versionierung (Postman, State of the API 2025). Das eigentliche Risiko ist Kommunikation, nicht Technik.
GraphQLs Ansatz hat auf dem Papier einen Vorteil: Ein Feld wird als veraltet markiert und bleibt bestehen, Clients migrieren in ihrem eigenen Tempo, es entsteht kein separater /v2-Zwilling. In der Praxis wächst das Schema damit monoton, und selten traut sich jemand, alte Felder tatsächlich zu entfernen.
Für dich als Integrator zählt eine andere Frage: Erfährst du von einer Änderung, bevor sie live geht? In der ATS-Landschaft ist die Antwort häufig nein. Deshalb sind Vertragstests gegen die fremde API und eine Alarmierung auf Schemaabweichungen wichtiger als die Wahl des Stils.
Warum ist Rate Limiting bei GraphQL schwerer zu kalkulieren?
Weil ein Request keine aussagekräftige Einheit mehr ist. Bei REST kostet ein Call einen Call, ein Limit von 1.000 Requests pro Stunde ist für beide Seiten planbar. Bei GraphQL kann eine einzige Query hundert Datensätze mit je fünf Relationen laden – der Aufwand steht im Query-Body, nicht in der Anzahl der Anfragen.
Anbieter lösen das über Kostenmodelle: Jedem Feld und jeder Listenauflösung wird ein Gewicht zugewiesen, das Limit gilt für die Summe. Das ist eine technisch saubere Lösung, aber für Client-Teams schwerer zu prognostizieren – du weißt vorab nicht sicher, ob eine Query in dein Budget passt. Fehlt dieses Kostenmodell, bleibt oft nur eine feste Tiefenbegrenzung pro Query, die einfache Abfragen unnötig einschränkt und komplexe trotzdem nicht sicher abfängt.
| Aspekt | REST | GraphQL |
|---|---|---|
| Einheit des Limits | Request pro Endpoint | Query-Komplexität oder Punkte |
| Vorhersagbarkeit für den Client | Hoch | Mittel bis niedrig |
| Schutz vor teuren Anfragen | Über Endpoint-Design | Über Tiefen- und Komplexitätslimits |
| Verbreitete Standardwerkzeuge | API-Gateway, Reverse Proxy | Meist eigene Middleware nötig |
Wenn du einen Sync-Job planst, der nachts hunderttausend Stellen abgleicht, ist ein Request-Limit die angenehmere Grundlage für Kapazitätsplanung. Die Kehrseite bleibt aber real: Ohne Tiefen- und Komplexitätslimits sind gerade öffentlich erreichbare GraphQL-Endpunkte anfällig – 69 % der von Escape 2024 gescannten Endpunkte hatten entsprechende Schwachstellen (Escape, State of GraphQL Security 2024).
mit deinem Stack?
Wie unterscheidet sich die Fehlerbehandlung in der Praxis?
Anders, als der verbreitete Merksatz „GraphQL antwortet immer mit HTTP 200" suggeriert. Die GraphQL-over-HTTP-Spezifikation erlaubt für Anfragefehler ausdrücklich 4xx- und 5xx-Codes – 400 bei nicht parsbarem JSON-Body oder GraphQL-Dokument, 422 bei fehlgeschlagener Validierung. Nur für ein tatsächlich ausgeführtes Query-Ergebnis, das teils Daten und teils Fehler enthält, empfiehlt die Spezifikation bei reinem application/json den Code 200 und bei der GraphQL-spezifischen Antwortform application/graphql-response+json den eigens dafür vorgesehenen Code 294 für „Partial Success" (GraphQL-over-HTTP-Spezifikation, GraphQL Working Group, Draft 2026).
Für eine Integration bleibt der praktische Unterschied trotzdem groß. Bei GraphQL kann eine Antwort teils Daten und teils Fehler enthalten. Für ein Frontend ist das komfortabel – es rendert, was da ist. Für einen Sync-Prozess ist es riskant: Ein Teilergebnis sieht wie ein Erfolg aus und schreibt möglicherweise unvollständige Daten weiter.
Praktisch heißt das: Bei GraphQL brauchst du eine explizite Regel, ab wann ein Teilergebnis als Fehlschlag gilt, und musst das errors-Array genauso streng prüfen wie einen Statuscode. Bei REST ist dieselbe Disziplin nötig, aber die Ausgangslage ist eindeutiger – ein 404 bedeutet 404, ein 429 bedeutet Retry, ein 422 bedeutet Datenfehler.
Welchen API-Stil solltest du für deine eigene Schnittstelle wählen?
Nach dem Nutzungsmuster deiner Clients, nicht nach Aktualität. Bediene viele unbekannte Clients mit unterschiedlichen Datenbedürfnissen und tiefen Relationen, spricht das für GraphQL – genau das Szenario, in dem die UW-Tacoma-Studie die deutlichsten Vorteile maß. Läuft der Verkehr über Maschine-zu-Maschine-Synchronisation, Webhooks und Batch-Jobs, ist REST die planbarere Basis, und für 93 % der Entwickelnden bereits vertraut (Postman, State of the API 2025).
| Wenn das zutrifft | Dann eher | Begründung |
|---|---|---|
| Eigenes Frontend mit tiefen Relationen | GraphQL | Weniger Roundtrips, ein Schema-Vertrag |
| Viele externe Clients, unbekannte Bedürfnisse | GraphQL | Clients holen sich, was sie brauchen |
| Server-zu-Server-Sync, Batch, Webhooks | REST | Kalkulierbare Limits, HTTP-Caching |
| Kleines Team, knappe Betriebskapazität | REST | Kein Aufbau eigener Caching- und Limit-Ebene |
| Bestehende REST-API, GraphQL zusätzlich gewünscht | Beides | GraphQL als zusätzliche Fassade, nicht als Ersatz |
Der ehrlichste Rat: Wähle den Stil, den dein Team dauerhaft betreiben kann. Eine gut dokumentierte, versionierte REST-API mit Webhooks ist für Integrationspartner meist wertvoller als ein GraphQL-Endpoint ohne Komplexitätslimits und ohne Changelog. Das gilt besonders, wenn dein Team klein ist: Die Caching- und Rate-Limiting-Ebene, die REST kostenlos über HTTP mitbringt, musst du bei GraphQL selbst bauen und danach auch dauerhaft betreiben.
Wenn du am Ende feststellst, dass der eigentliche Aufwand nicht im API-Stil liegt, sondern in mehreren unterschiedlichen Schnittstellen mit mehreren Auth-Verfahren, sprich uns an – kein Pitch, nur ein Blick auf deine Systemliste.